 LocalAI
小核心 + 按需拉取的后端镜像
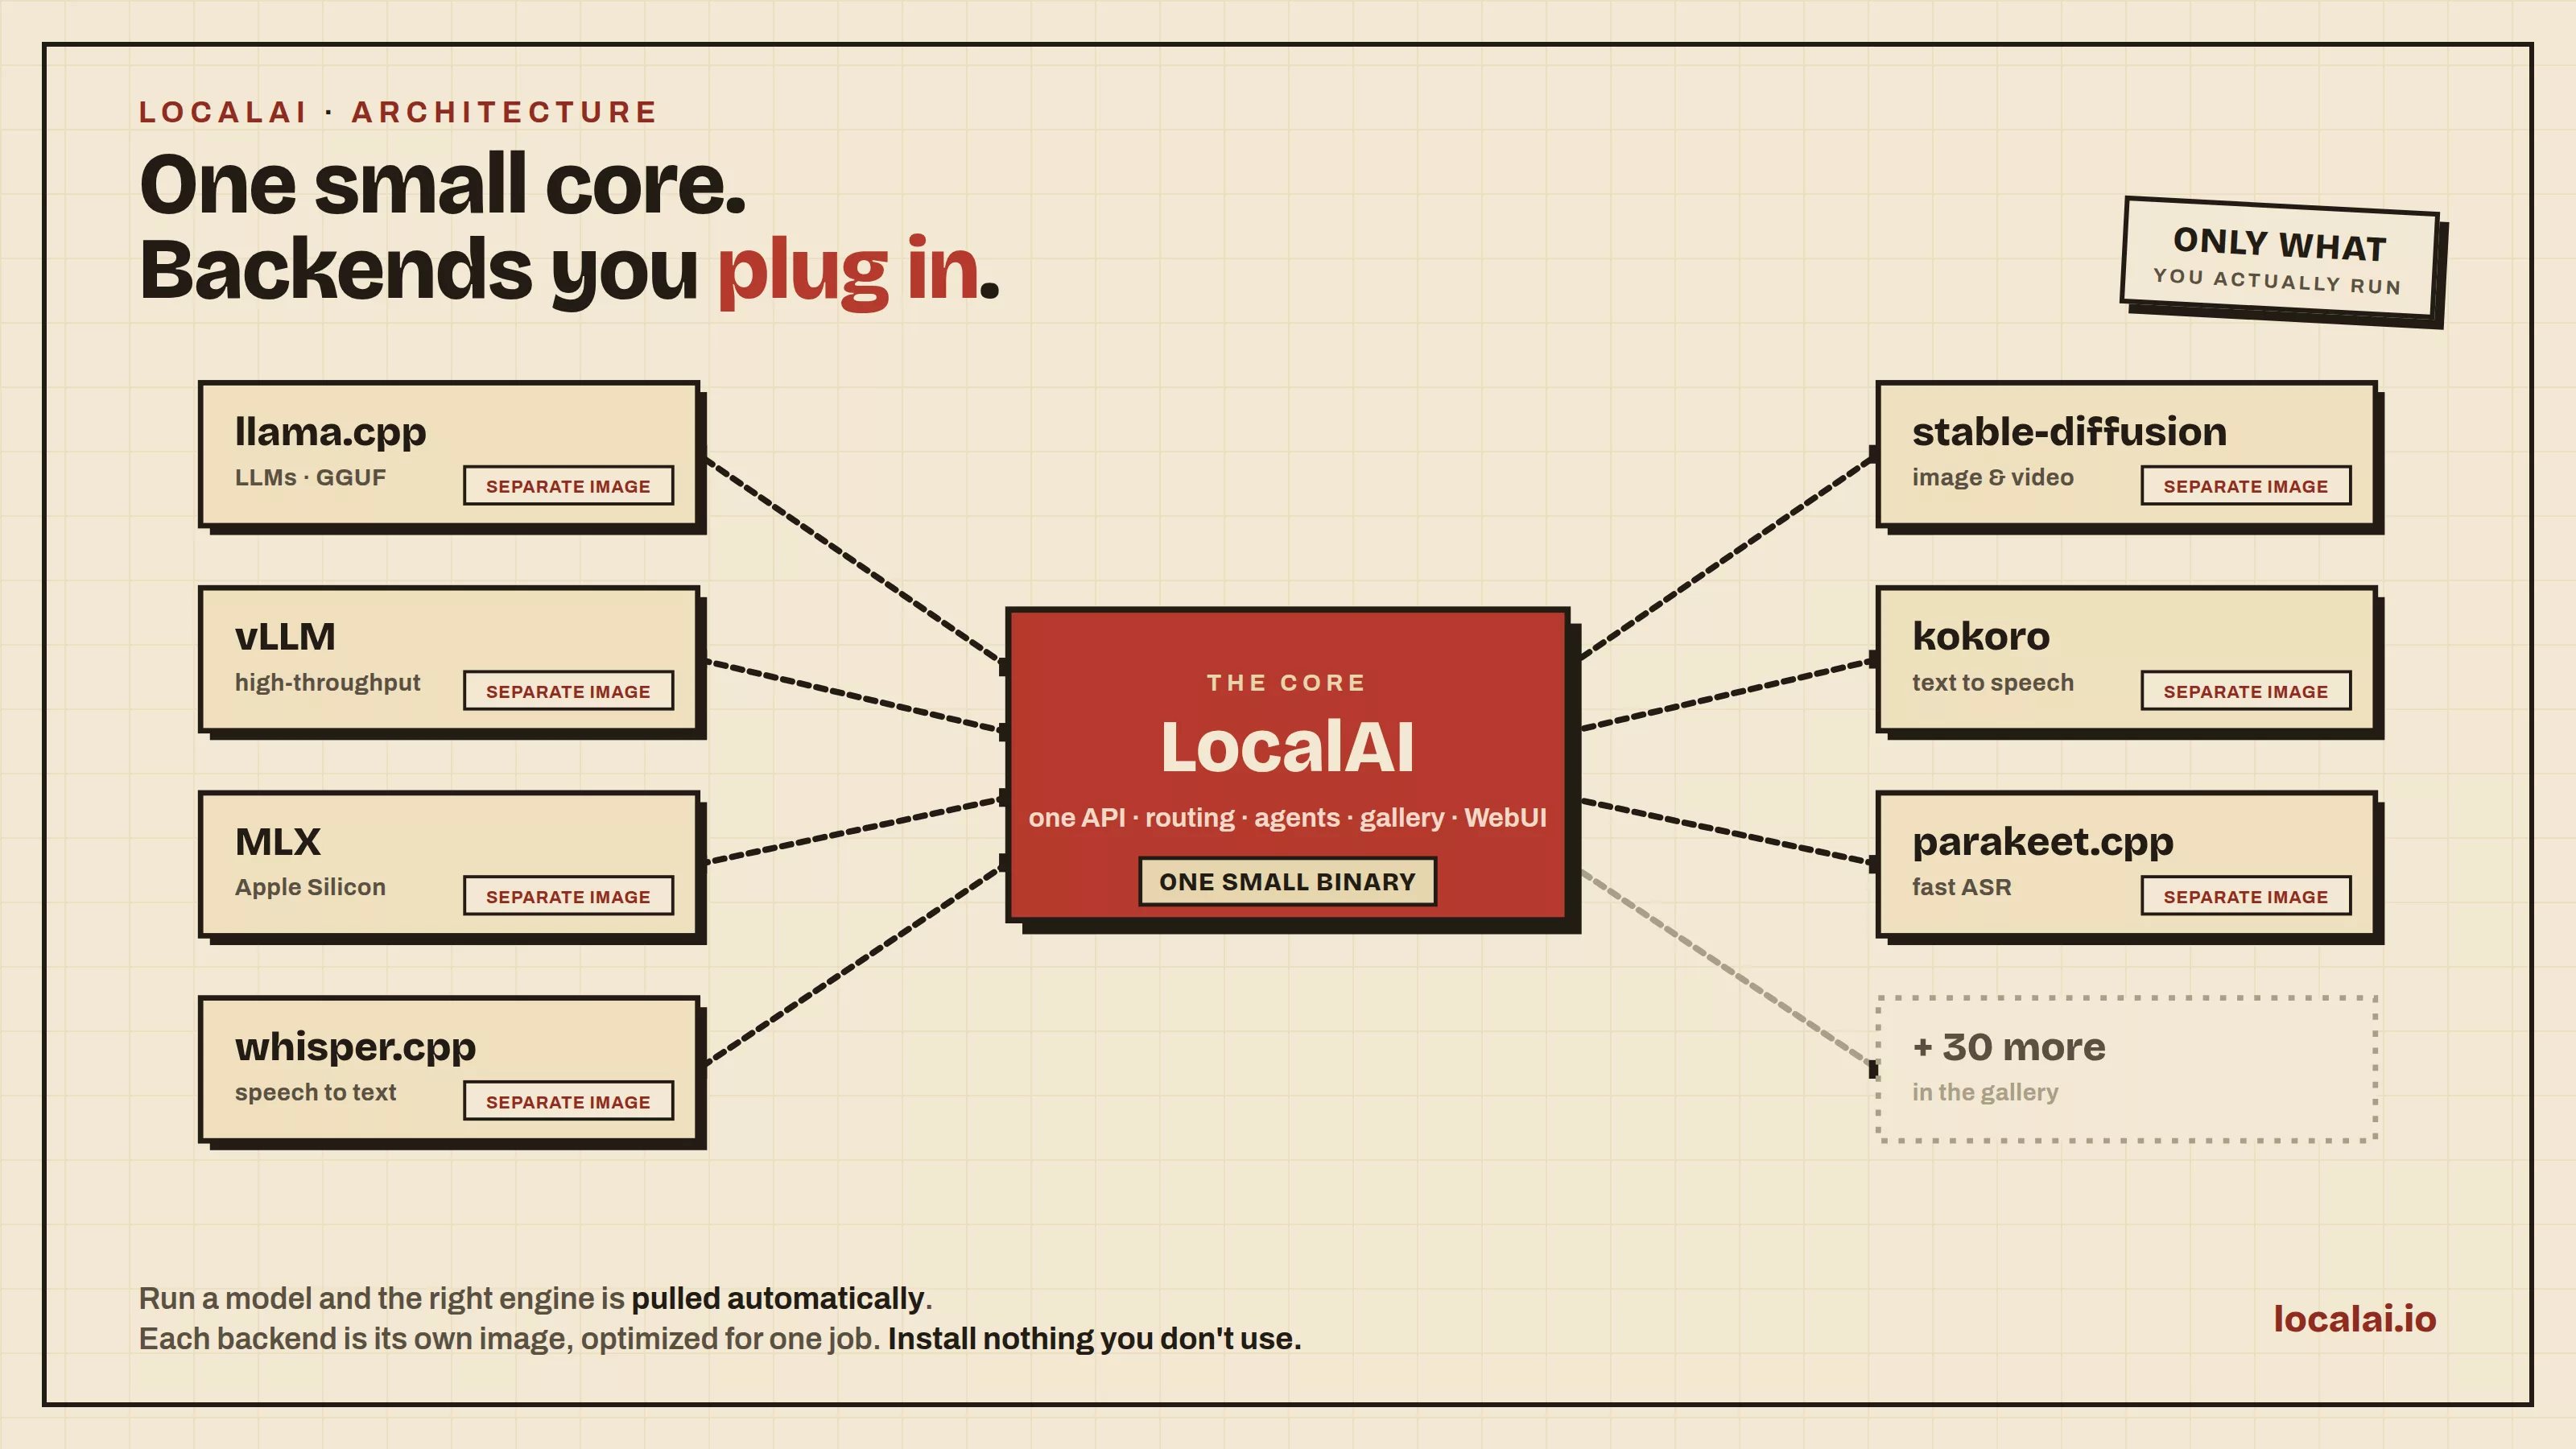
官方把架构概括为「一个小核心,而不是一整包」:每个后端把某个上游引擎(llama.cpp、vLLM、whisper.cpp、stable-diffusion、MLX 等)封装进自己的容器镜像,只有在某个模型需要时才拉取,官方描述为「你没用到的东西不会装上」。这条设计的直接好处是镜像体积与依赖面都可控——装文本模型不必拖进语音与图像栈;代价是第一次使用某类模型时需要联网拉取对应后端镜像,离线环境要提前把镜像准备好。官方也提供后端库页面,用于在运行中安装或移除后端。
深度介绍
官方把架构概括为「一个小核心,而不是一整包」:每个后端把某个上游引擎(llama.cpp、vLLM、whisper.cpp、stable-diffusion、MLX 等)封装进自己的容器镜像,只有在某个模型需要时才拉取,官方描述为「你没用到的东西不会装上」。这条设计的直接好处是镜像体积与依赖面都可控——装文本模型不必拖进语音与图像栈;代价是第一次使用某类模型时需要联网拉取对应后端镜像,离线环境要提前把镜像准备好。官方也提供后端库页面,用于在运行中安装或移除后端。
官方称支持 60 多个后端,包括 llama.cpp、vLLM、SGLang、transformers、whisper.cpp、diffusers、MLX 与 MLX-VLM 等,并给出硬件加速矩阵:NVIDIA(CUDA 12/13,含 Jetson L4T)、AMD(ROCm)、Intel(oneAPI/SYCL)、Apple Silicon(Metal)以及 Vulkan,官方强调 CPU-only 也能跑。命令行与容器镜像按硬件分:CPU、CUDA 12/13、ROCm、Intel、Vulkan 各有独立 tag,启动时官方称会自动检测 GPU 能力并拉取合适的后端。对使用者而言,这意味着同一套模型文件可以在不同机器上复用,只需换镜像或后端。
官方把「drop-in 兼容」列为核心特性:同一组后端之上同时提供 OpenAI、Anthropic 与 ElevenLabs 三种 API 风格的接口,并且覆盖全部模态——文本、视觉、语音、图像与视频走同一套服务。文档里可查的接口面包括聊天补全与函数调用、Realtime API(语音到语音)、嵌入、重排、视觉与目标检测、图像生成、约束语法输出、语音转写与合成,另有模型上下文协议(MCP)支持。对已有应用,这意味着迁移成本主要落在模型与参数适配,而不是重写调用层;实际接入前建议按自身用到的端点逐个核对行为差异。
面向团队的部分在 4.x 版本补齐得比较完整:API Key 认证、按用户配额与用量统计、基于角色的访问控制,以及 OIDC 接入;官方在 4.3.0 的更新说明里还提到按 API Key 与按用户的用量归属,便于内部核算。配合内置 WebUI 与按用户的指标视图,可以当作小型的内部模型网关使用。需要注意这些都是自托管能力——审计日志、密钥轮换与备份策略仍需自行设计,官方不提供托管侧的安全兜底。
官方在 4.0 版本引入原生 Agent 编排,并在后续版本补齐了工具调用、RAG、技能(skills)与 SSE 流式输出,另设社区 Agent 中心供分享。命令行侧提供终端 Agent:它会回答问题、读取本机文件并执行命令,任何改变系统状态的操作都要先经使用者确认;会话里可用斜杠命令列出模型与切换模型。官方在 2026 年 6 月的更新中还加入 RAG 来源引用。做内部工具时值得留意的是权限边界——Agent 能读文件与跑命令,部署在多人环境前需要明确它被允许访问的目录与命令范围。
语音是 LocalAI 投入很重的一条线:官方支持语音活动检测(Silero-VAD)、语音转写、说话人分离、文本转语音,以及语音到语音的 Realtime API,并支持 WebRTC 实时音频与可配置的 ICE 候选。相关后端既有封装上游引擎的,也有团队自研的原生 C/C++ 与 GGML 实现,例如 parakeet.cpp(NeMo Parakeet 的 ASR 移植,支持流式转写)、moss-transcribe.cpp(长音频转写与说话人分离一次完成)、以及多个 TTS 端口(含语音克隆与多语言音色)。需要实测的是实时链路的端到端延迟与并发转写的批处理表现,官方在这些点上有持续的优化记录。
官方特性列表里的模态相当宽:图像生成、视频生成、视觉问答、目标检测与实例分割、单目深度与相机位姿、开放词表检测、人脸检测与识别、语音与图像的隐私过滤,以及无位姿三维重建与单图生成带材质的三维网格。这些能力大多由项目自研或移植的原生引擎提供,例如 stablediffusion-ggml、rf-detr.cpp、depth-anything.cpp、locate-anything.cpp、face-detect.cpp、free-splatter.cpp 与 trellis2.cpp 等。对做内容与多模态应用的团队,好处是用一个服务覆盖生成、理解与检测;代价是每类模型仍需单独准备权重与后端镜像。
部署路径分三层。单机:macOS 有桌面应用(官方提示 DMG 未签名,安装后需执行一次解除隔离的命令),Linux 与 Windows 侧主要走容器。模型来源很灵活——官方模型库、Hugging Face(huggingface:// 前缀)、Ollama 注册表(ollama://)、标准 OCI 镜像(oci://),或一个 YAML 配置的 URL,命令行一条 local-ai run 即可。扩展层是分布式模式:用 PostgreSQL 与 NATS 做水平扩展,支持 P2P 推理、前缀缓存感知的路由与按请求的副本路由,官方在 4.1 之后的版本里持续加固认证(NATS JWT、TLS/mTLS)与可恢复上传等细节。
产品特点
每个后端封装一个上游引擎并独立成镜像,只有模型用到时才拉取,官方描述为「用不到的不装」。好处是依赖与体积可控,代价是首次使用某类模型需要联网取镜像。
除封装上游项目外,团队还自研或移植了一批原生引擎:vllm.cpp(C++ 版 vLLM,含分页 KV 缓存与连续批处理)、parakeet.cpp、moss-transcribe.cpp、多个 TTS 端口、rf-detr.cpp、depth-anything.cpp、face-detect.cpp、privacy-filter.cpp 等,推理时不依赖 Python 与 onnxruntime。
同一组后端之上提供 OpenAI、Anthropic 与 ElevenLabs 三种兼容接口,覆盖文本、视觉、语音、图像与视频。已有应用通常只需改基址与模型名,而不用重写调用层。
既能跑在一台笔记本上,也能用 PostgreSQL 与 NATS 组成水平扩展的集群,支持 P2P 推理、前缀缓存感知路由与按请求的副本路由;多用户侧提供 API Key、配额与角色权限。
最近动态
官方在 2026 年 6 月的更新中引入自研的 voice-detect.cpp(说话人识别与语音分析)与 face-detect.cpp(人脸检测、识别与防伪),并推进 parakeet.cpp 的流式转写、CUDA graphs 与动态批处理;分布式侧加入前缀缓存感知路由、生产级请求路由、NATS 的 JWT 认证与 TLS/mTLS。
4.3.0 让 llama.cpp 的提示缓存默认开启,官方称重复长系统提示的耗时从分钟级降到秒级;同时为后端 OCI 镜像引入无密钥的 cosign 签名校验,并加入按 API Key 与按用户的用量归属,以及带每请求副本路由的 Distributed v3。
4.1.0 把 LocalAI 定位为「控制塔」:加入分布式集群模式与显存感知的智能路由和自动扩缩,多用户平台支持 OIDC 与 API Key、按用户配额与预测分析,并提供界面内微调(对接 TRL 并自动导出 GGUF)、即时量化后端与可视化流水线编辑器。
4.0.0 引入原生 Agent 编排与社区 Agent 中心,前端重写为 React 并加入 Canvas 模式,支持 MCP Apps 与工具流式输出、WebRTC 实时音频,以及 MLX 的分布式运行。此后 3.10.0 又补齐 Anthropic API、Open Responses API 与视频图像生成等能力。
LocalAI 是 Ettore Di Giacinto 创建、由 LocalAI 团队维护的开源 AI 引擎,官方定位是「让 AI 跑在每台机器上」:在自备硬件上运行文本、视觉、语音、图像与视频模型,并明确表示无需 GPU。项目以 MIT 许可开源,核验时约有 4.9 万 star,最新版本为 v4.3.0。架构上它是「小核心 + 按需后端」:每个后端把 llama.cpp、vLLM、whisper.cpp、stable-diffusion、MLX 等上游引擎封装成独立容器镜像,只在模型需要时拉取,因此不会把用不到的依赖一起装上;官方称支持 60 多个后端,并提供在运行中安装或移除后端的后端库。 接口层强调 drop-in 兼容:同一组后端之上同时提供 OpenAI、Anthropic 与 ElevenLabs 三种 API 风格,覆盖聊天补全与函数调用、Realtime 语音到语音、嵌入、重排、视觉与目标检测、图像生成、约束语法与语音转写合成,另支持模型上下文协议。硬件加速覆盖 NVIDIA(CUDA 12/13,含 Jetson L4T)、AMD(ROCm)、Intel(oneAPI/SYCL)、Apple Silicon(Metal)与 Vulkan,官方称启动时会自动检测 GPU 能力并拉取匹配的后端镜像,CPU-only 也可运行。 面向团队的能力在 4.x 版本逐步补齐:API Key 认证、按用户配额与用量归属、角色权限、OIDC 接入,以及内置的多用户界面与按用户指标;Agent 侧支持工具调用、RAG、技能与流式输出,命令行还提供会读文件、跑命令并逐步征求确认的终端 Agent。模态覆盖也很宽:除语言模型外还有图像与视频生成、视觉问答、目标检测、深度估计、人脸与语音分析、三维重建等,多数由项目自研或移植的原生 C/C++ 与 GGML 引擎提供,推理时不依赖 Python 与 onnxruntime。部署可以是一台笔记本,也可以是用 PostgreSQL 与 NATS 组成的分布式集群,并支持 P2P 推理与前缀缓存感知路由。 上手前需要注意:macOS 的 DMG 官方说明未签名,安装后需手动解除隔离;Linux 与 Windows 侧主要走容器,首次使用某类模型要联网拉取对应后端镜像,离线环境需提前准备;文本以外的模态都要单独准备权重与后端;Agent 能读文件并执行命令,开放给多人使用前应明确权限边界;分布式与多用户相关的认证(如 NATS 的 JWT 与 TLS/mTLS)需按官方文档自行配置。整体而言,它适合希望把多模态模型能力放在自己机房或内网、并愿意承担自运维成本的团队;只想要一个开箱即用的云接口则不是它的定位。
核验信息
本页事实来自 LocalAI 官方渠道:GitHub 仓库 README(「开源 AI 引擎」定位、无需 GPU、小核心与按需后端、后端与硬件矩阵、OpenAI/Anthropic/ElevenLabs 兼容、多用户与配额、内置 Agent、模型装载方式与容器命令、自研原生引擎清单、按月份记录的版本与新闻时间线,含 4.0.0 至 4.3.0 的更新要点)以及官方站点与文档(官网定位、后端库与模型库入口、快速开始、分布式模式、Agent 与兼容性页面)。star 数、版本号与时间线核验于 2026 年 9 月 22 日,功能与版本变化较快,请以官方最新文档为准。
LocalAI介绍页面对您是否有帮助?